튜토리얼 목록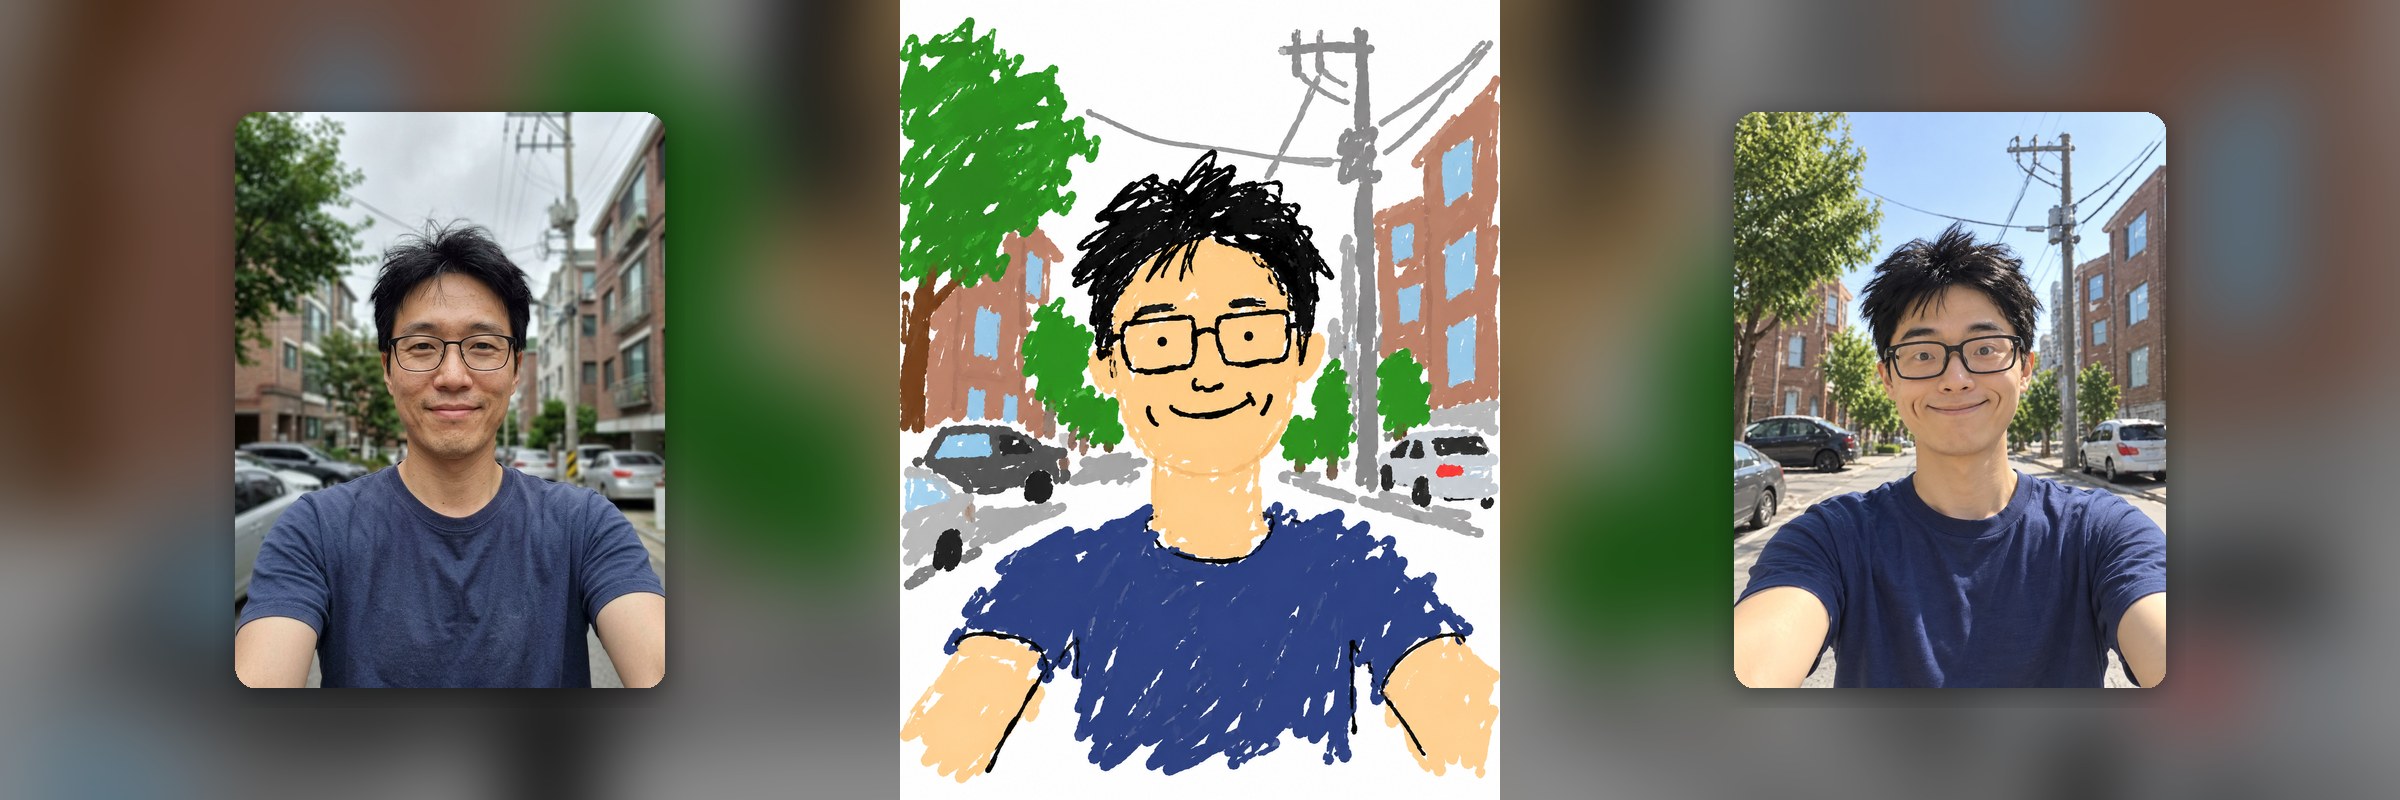 이 단계 따라 하기 ⚡ 약 110
그림체 변환 · 쉬움
하찮은 그림 왕복 — 사진 → 그림판 낙서 → 다시 사진
한국에서 시작해 세계로 번진 '하찮은 그림', 그리고 그 낙서를 다시 현실로
🧾 아무 사진 1장⚡ 약 220크레딧2단계by 고구마
올해 봄, 국내 한 크리에이티브 디렉터가 스레드에 올린 '하찮은 그림' — 사진을 마우스로 그림판에 대충 그린 듯한 낙서로 바꾸는 놀이 — 이 해외로 번지며 큰 유행이 됐어요. 이 튜토리얼은 거기에 한 단계를 더해요. 그 낙서를 다시 사진으로 되돌리면 어떻게 될까?
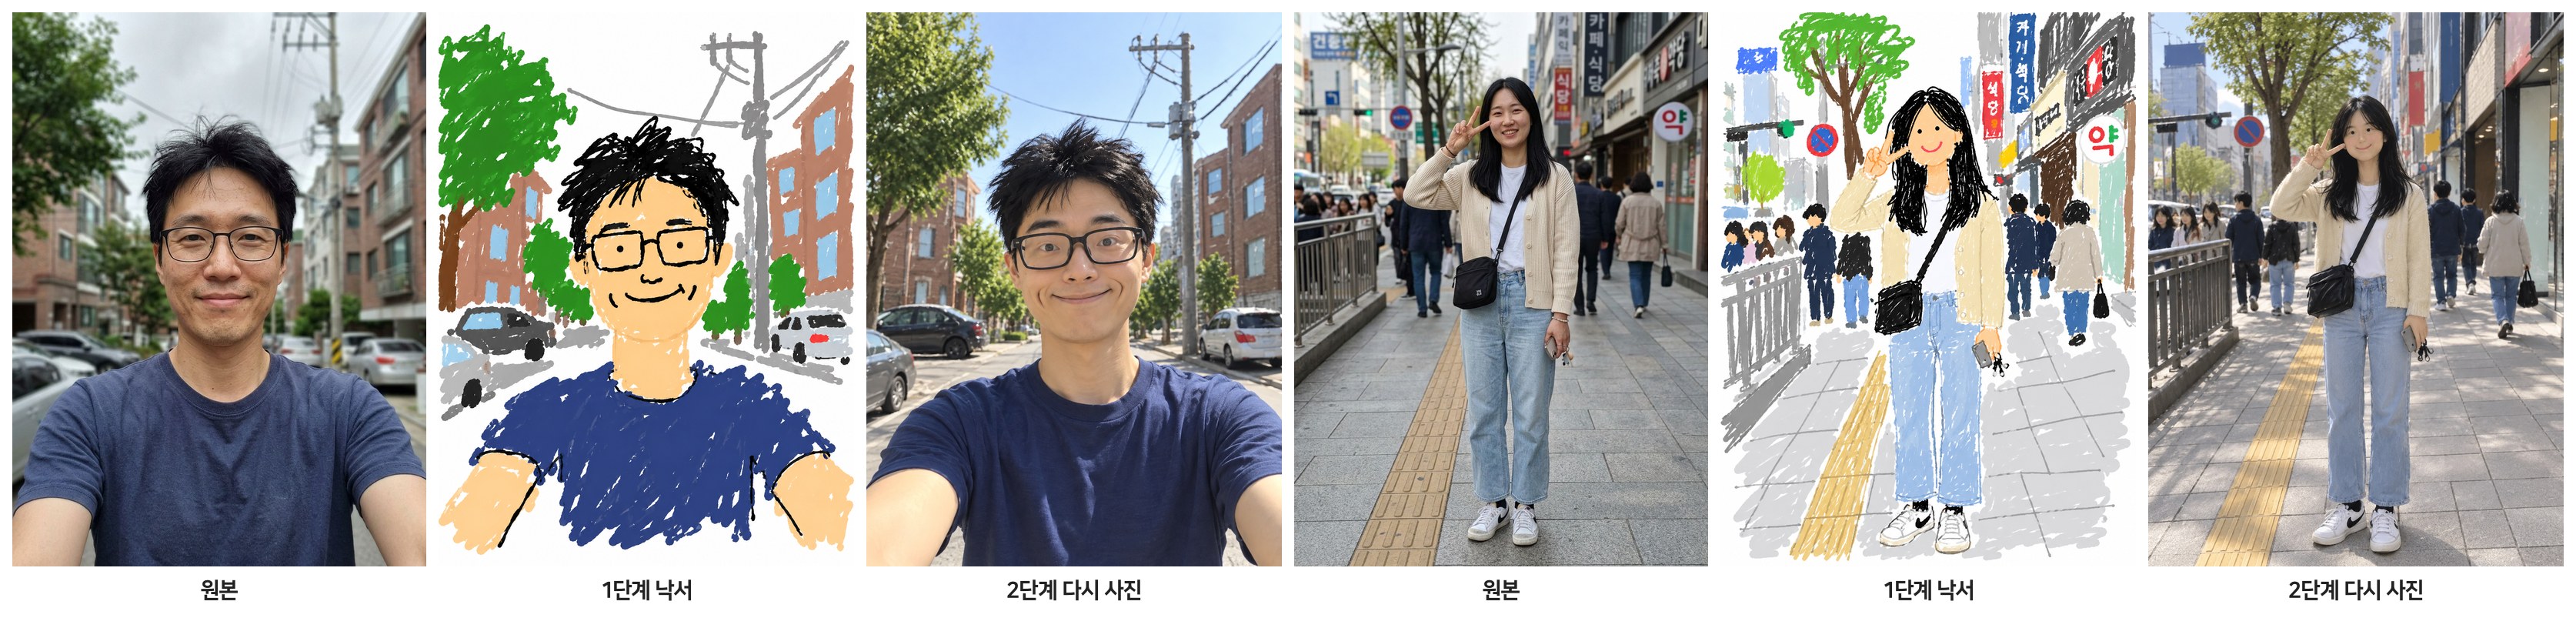
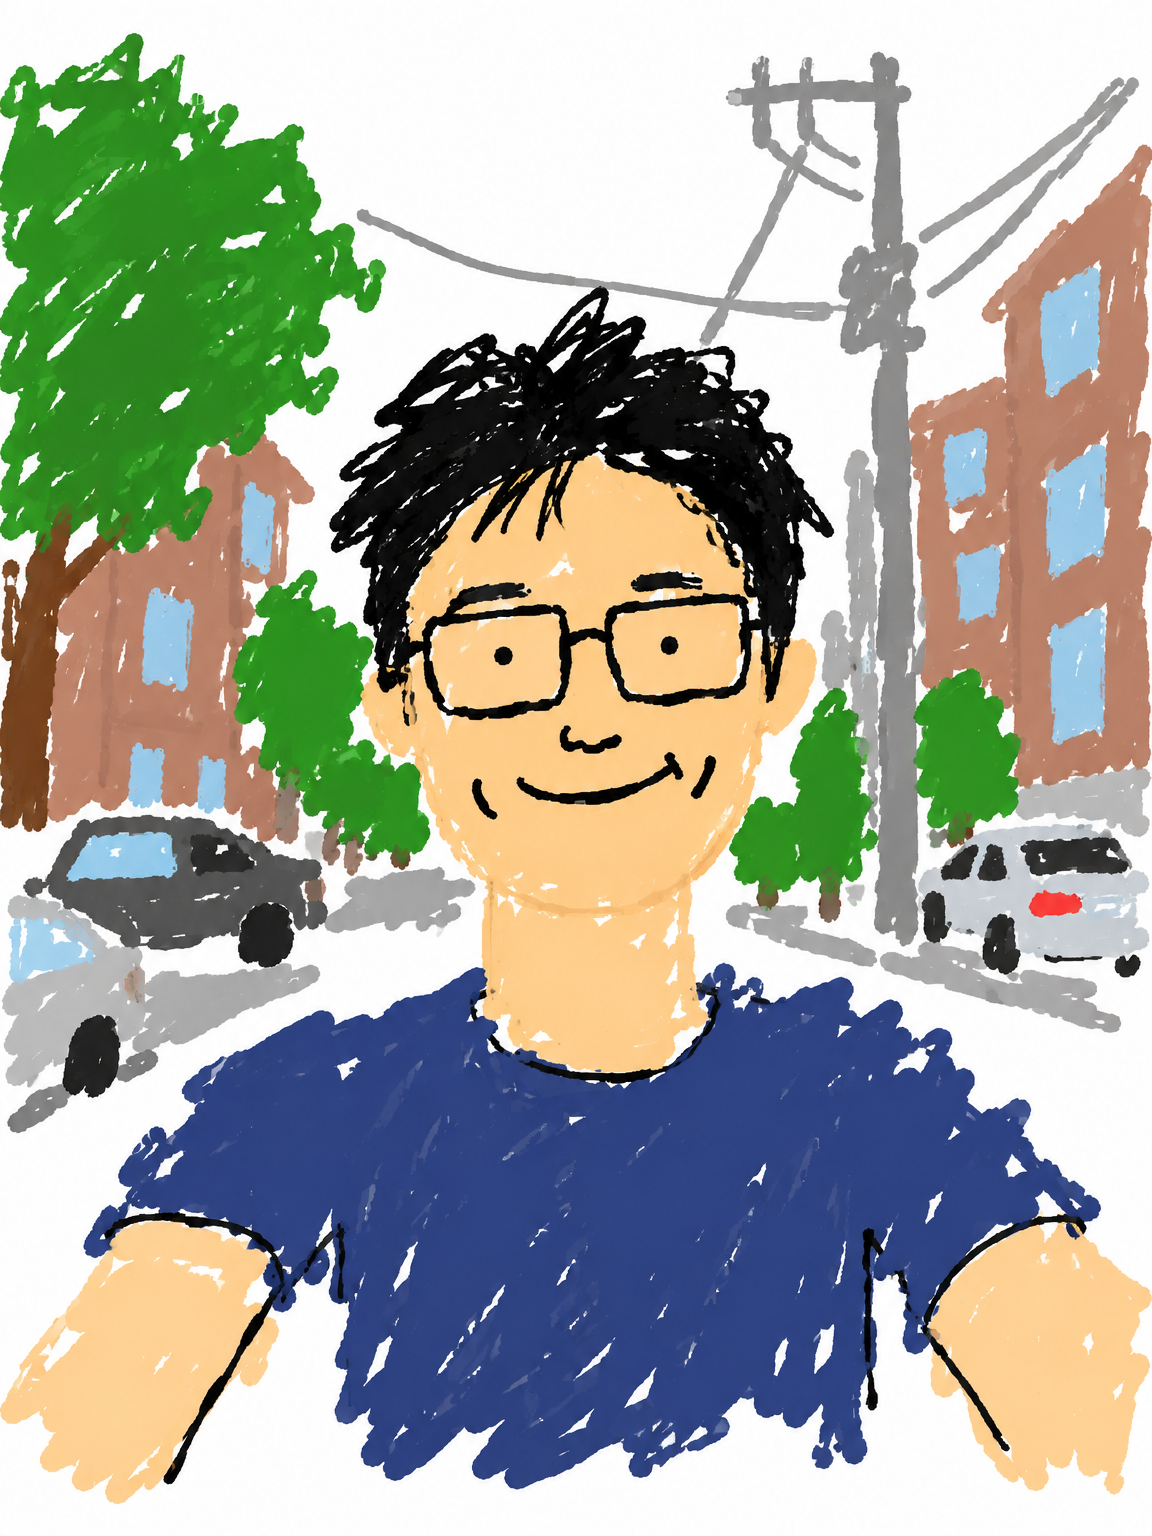
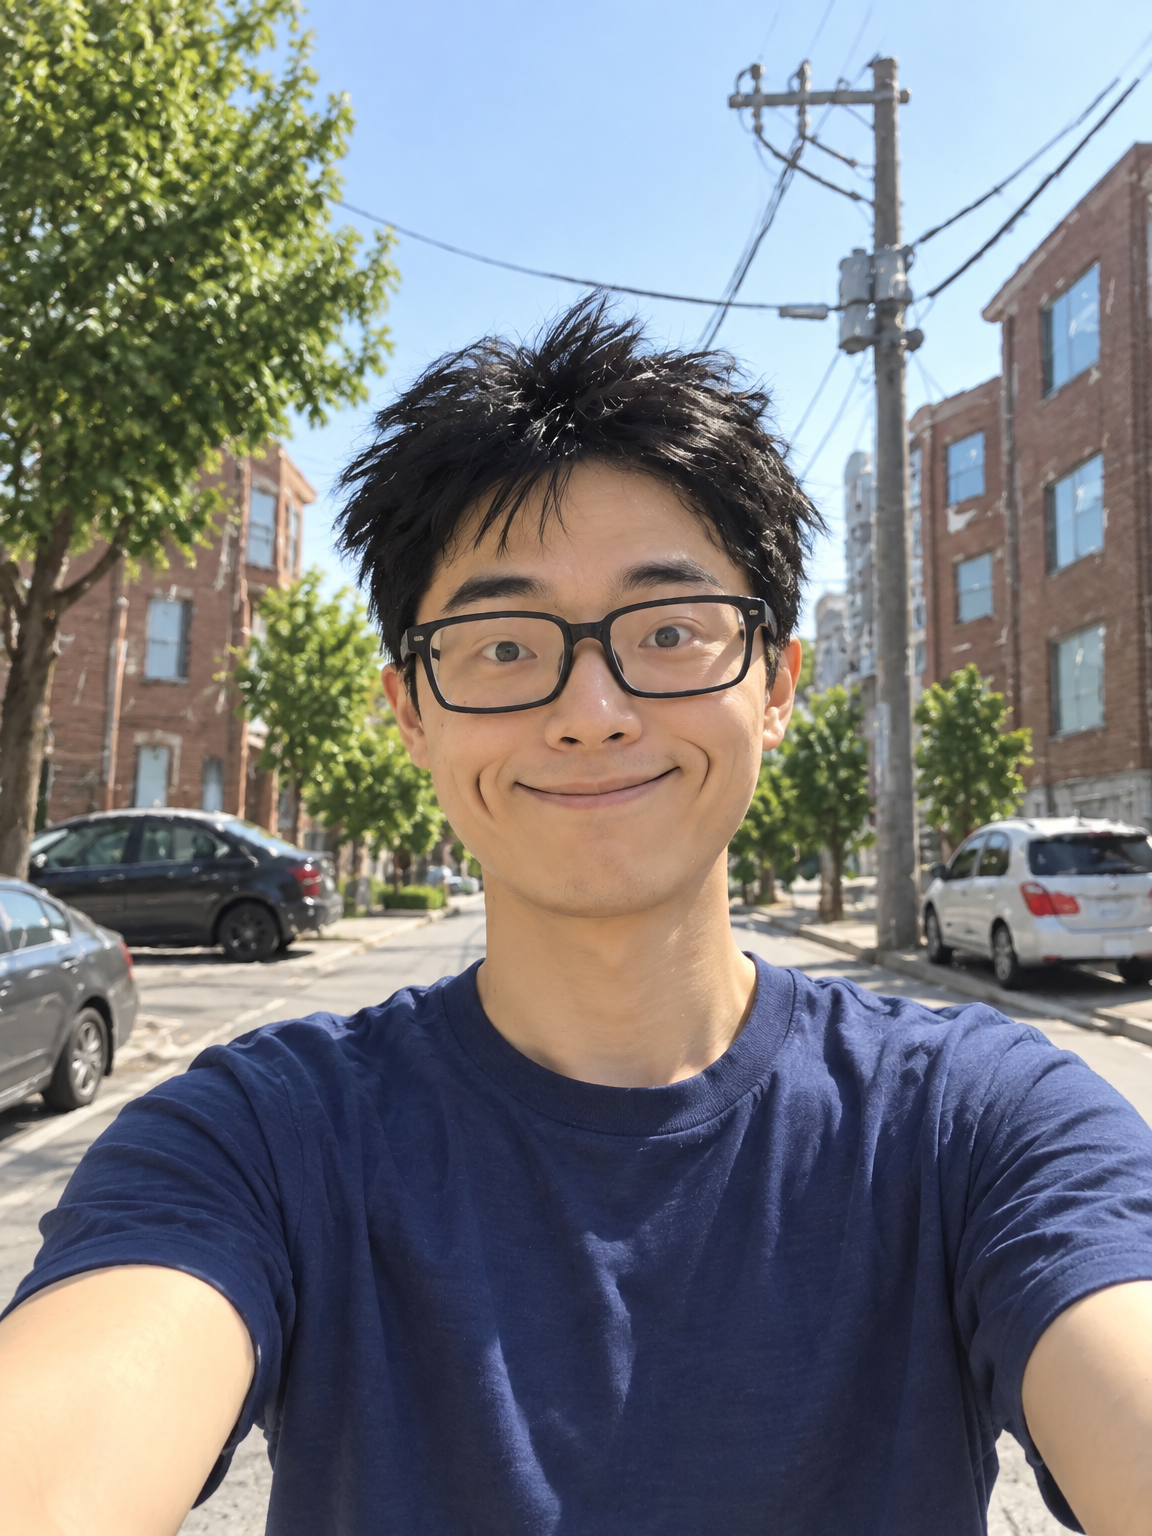
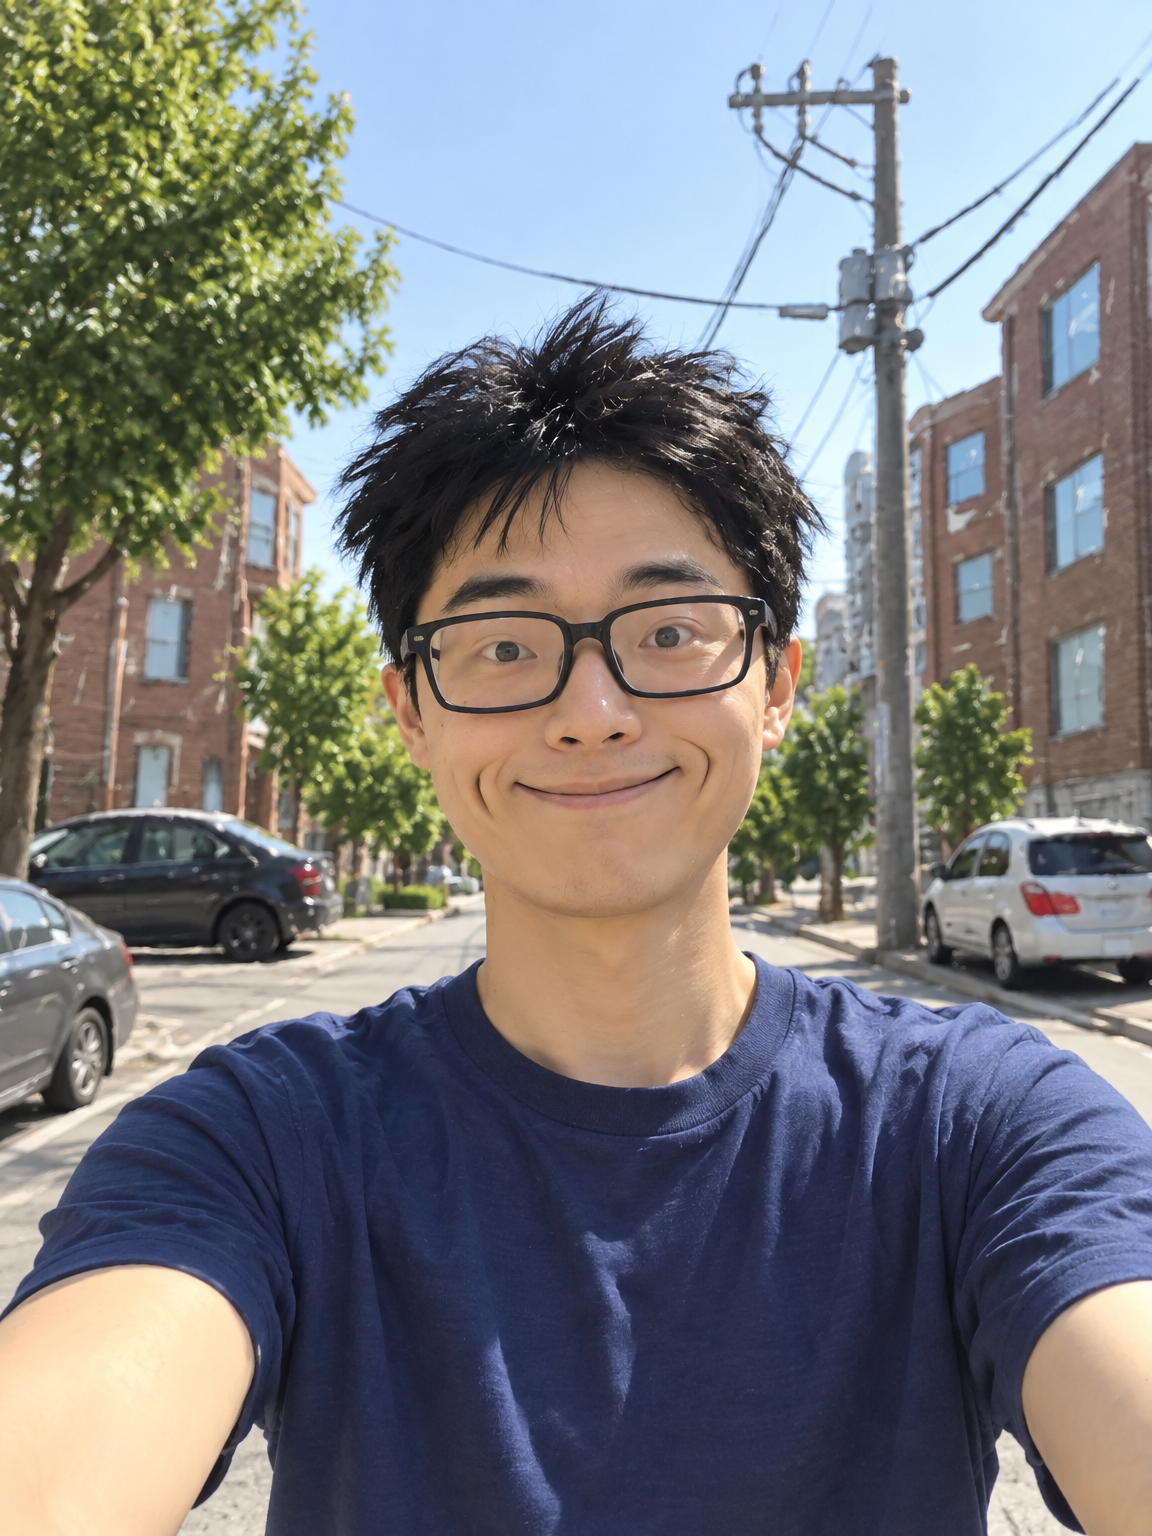
결과는 '말 전달 게임' 같아요. 옷 색과 안경, 배경은 돌아왔는데 얼굴은 원본과 다른 사람이 됐어요. 웃긴 결과지만, 동시에 AI 이미지에서 가장 중요한 원리 하나를 눈으로 보여 줘요 — 입력에 없는 정보는 모델이 지어낸다.
※ 예시에 나오는 인물은 모두 AI로 만든 가상 인물입니다.
1
하찮은 낙서로 바꾸기
사진을 올리고 생성하세요.
'못 그린 그림'을 주문하는 법
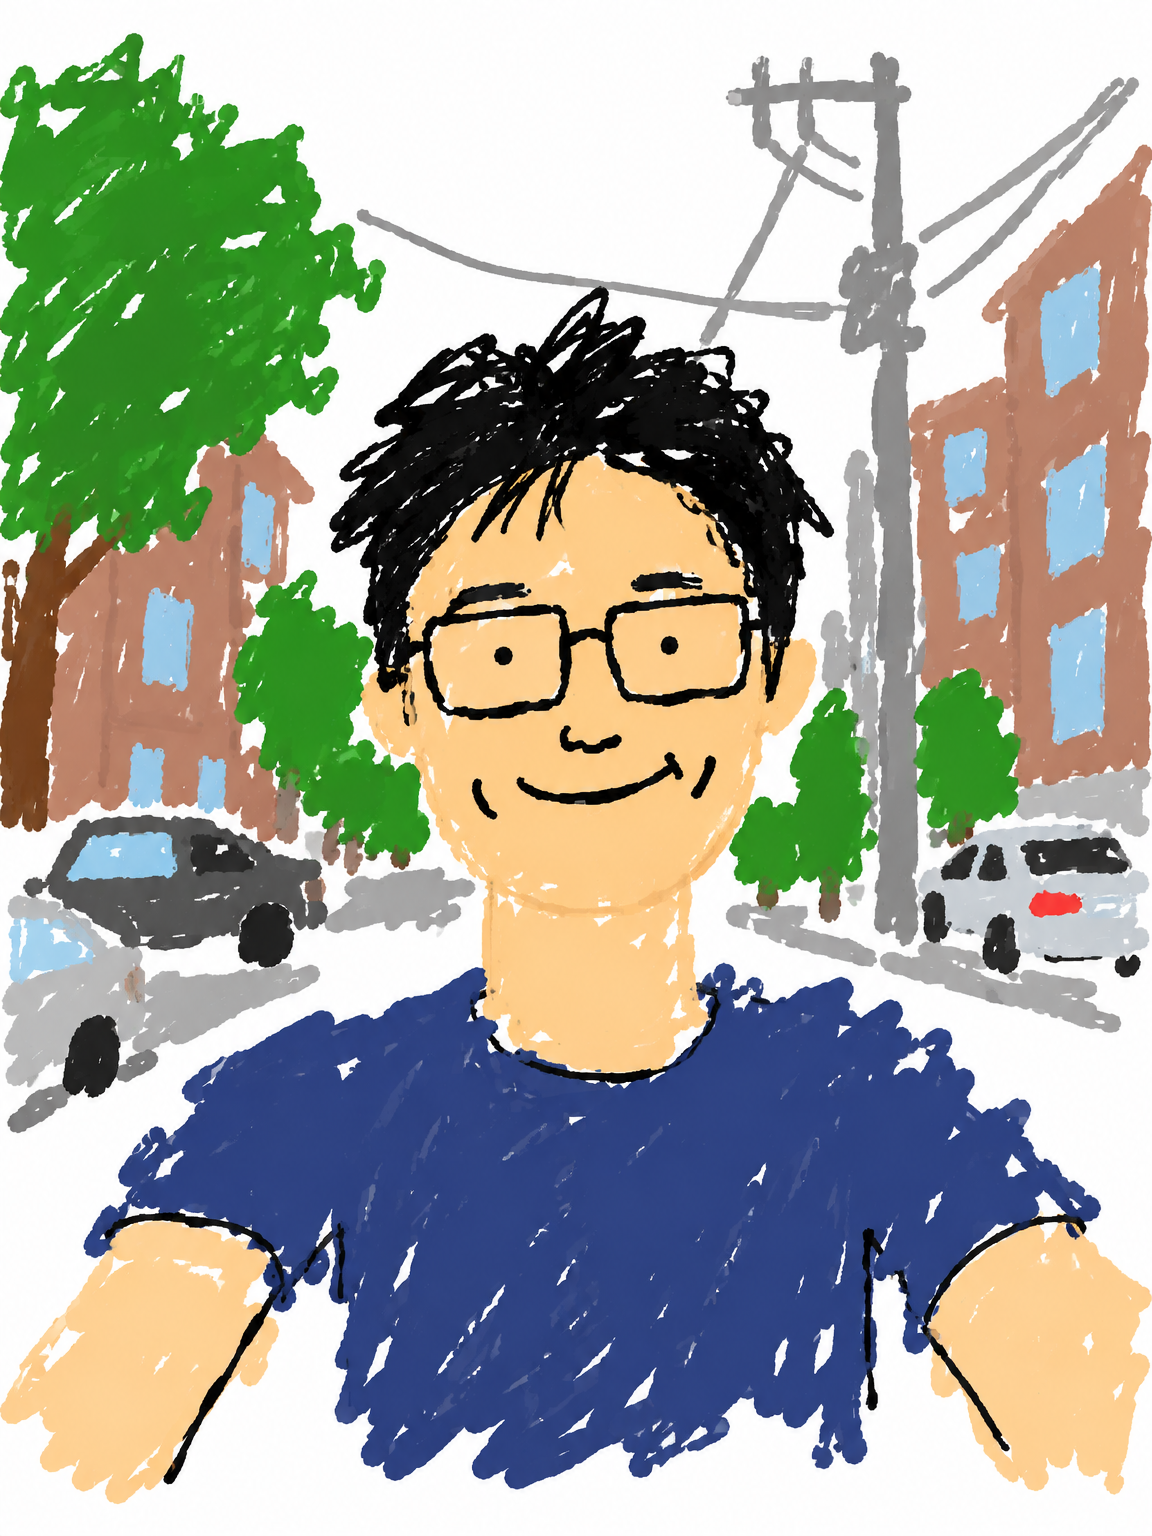
AI는 기본적으로 잘 그리려고 해요. 그래서 서툰 흔적을 하나씩 지정해야 해요.
- 도구 — "마우스 하나로 MS 그림판에". 도구를 정하면 선의 떨림과 단색 채우기가 따라와요.
- 서툰 증거 — "삐뚤빼뚤 떨리는 선, 선 밖으로 삐져나온 페인트통 색, 엉망인 신체 비율, 점 두 개로 찍은 눈"
- 그래도 알아보게 — "머리 모양, 안경, 옷 색은 알아볼 수 있게". 이 줄이 있어야 '하찮지만 누군지는 아는' 그림이 돼요.
- 화면 요소 금지 — "그림판 화면·메뉴·글자는 넣지 않기". 안 쓰면 그림판 창 전체를 그리기도 해요.
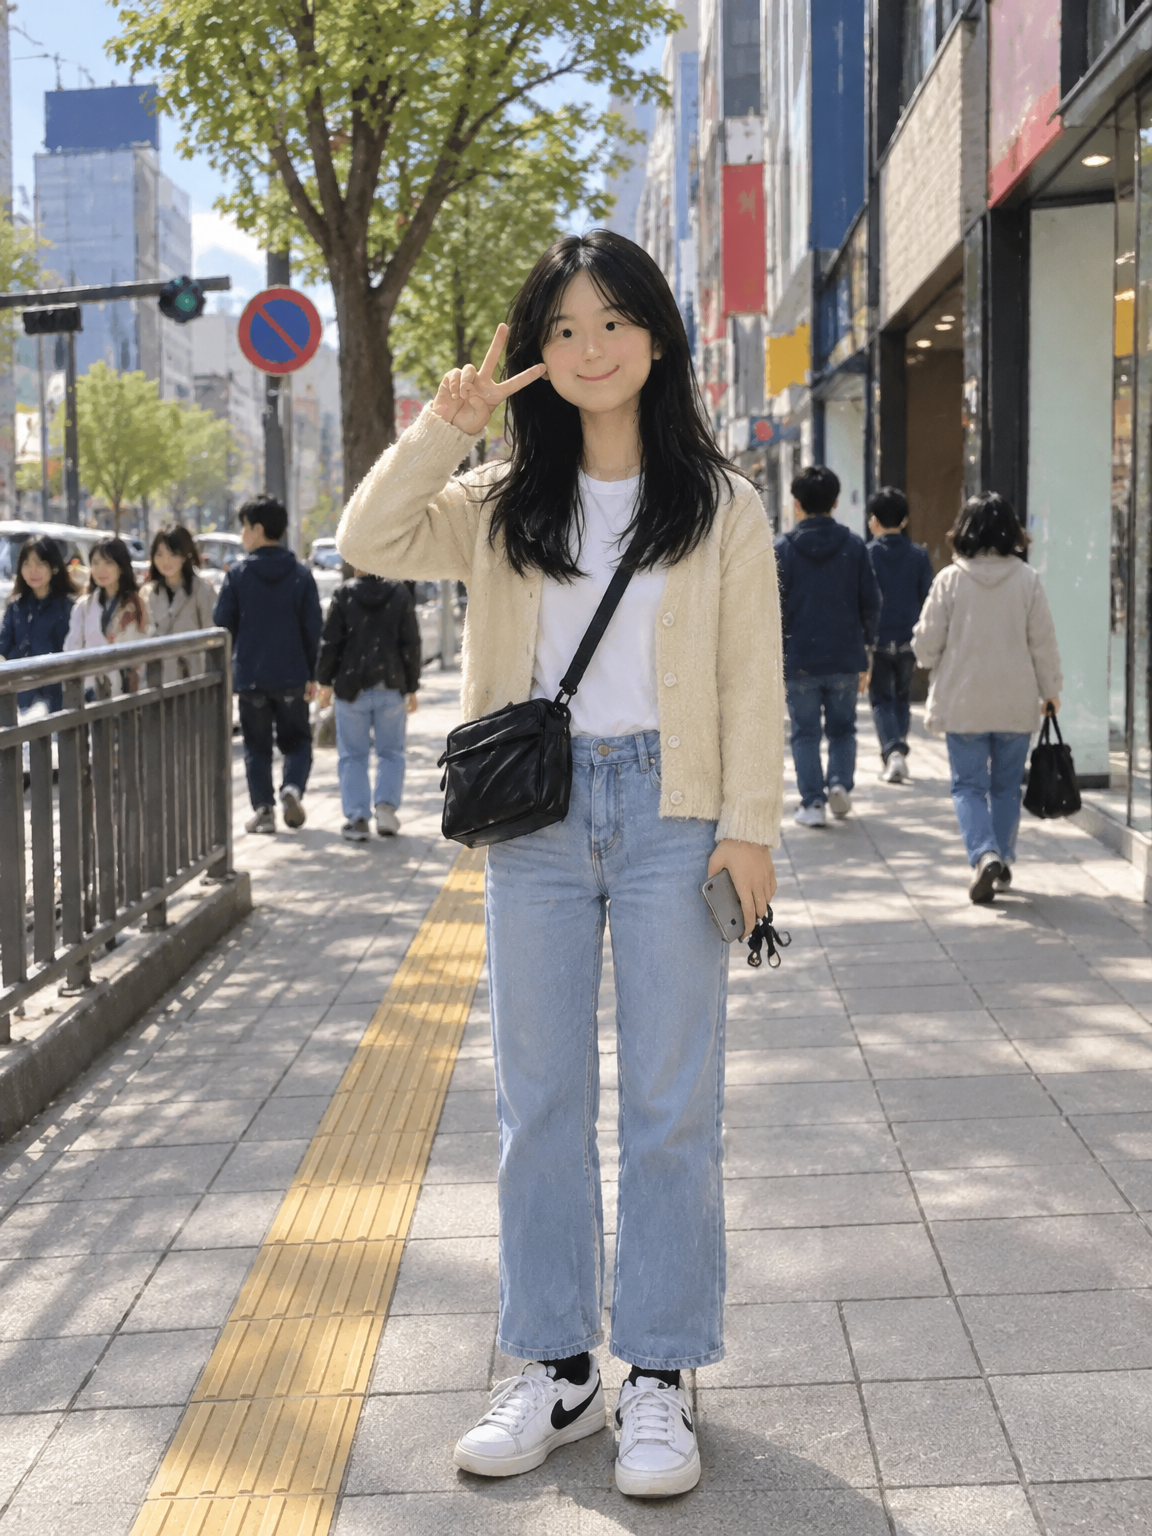
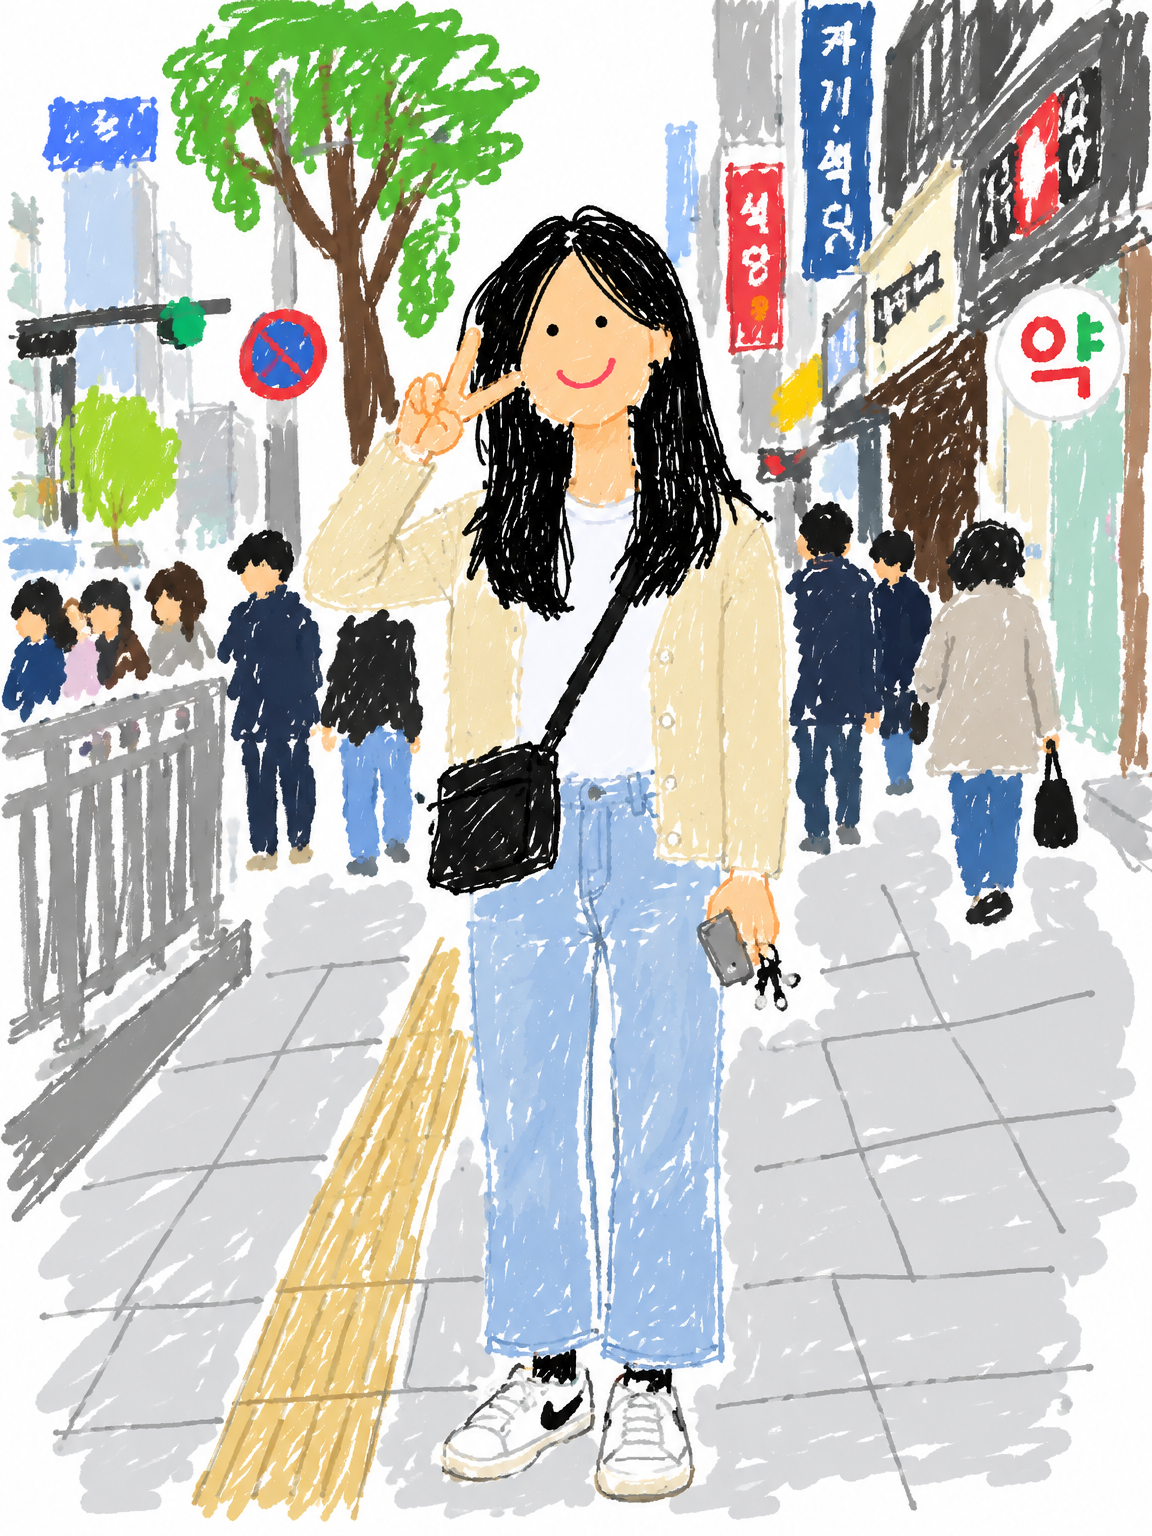
참고로 배경이 복잡한 전신 사진(위 비교의 오른쪽)은 모델이 간판까지 성실하게 따라 그려서 덜 '하찮게' 나왔어요. 얼굴 위주의 단순한 사진일수록 이 트렌드다운 결과가 나와요.
프롬프트·설정 보기
모델 · GPT Image 2.5 Sunburst
이 사진을 마우스 하나로 MS 그림판에 대충 그린, 어설프고 유치한 낙서로 다시 그려 주세요.

- 삐뚤빼뚤 떨리는 선, 페인트통으로 칠해 선 밖으로 삐져나온 색, 엉망인 신체 비율, 점 두 개로 찍은 눈
- 그래도 사진 속 인물의 특징(머리 모양, 안경, 옷 색, 배경의 큰 덩어리)은 알아볼 수 있게
- 흰 캔버스에 그림만 — 그림판 화면·메뉴·글자는 넣지 않기
| 품질 | medium |
| 비율 | 3:4 |
2
낙서를 다시 사진으로
1단계 낙서를 히스토리에서 편집할 이미지로 붙이고 생성하세요. 원본 사진은 넣지 않는 게 이 놀이의 규칙이에요.
무엇이 돌아오고, 무엇이 사라졌나
- 돌아온 것 — 남색 티셔츠, 검은 안경, 뻗친 머리, 전봇대와 벽돌 건물. 낙서에 분명히 그려진 것들이에요.
- 사라진 것 — 얼굴. 낙서에는 '점 두 개와 웃는 입'만 있으니, 모델은 그 정보에 맞는 새 얼굴을 지어냈어요. 나이도 훨씬 어려졌고요.
이게 바로 증명사진 튜토리얼에서 "얼굴이 크게 나온 선명한 사진을 넣으라"고 한 이유예요. 모델은 보이지 않는 것을 상상으로 채우고, 그 상상은 원본과 같지 않아요.
이렇게 놀아 보세요
- 친구와 릴레이 — 사진 → 낙서 → 사진 → 낙서… 몇 번 만에 다른 사람이 되는지 세어 보세요.
- 반려동물 버전 — 털 색과 무늬가 뚜렷한 동물은 어떻게 돌아올까요? 사람과 비교해 보세요.
- 내 손그림으로 — 종이에 직접 그린 낙서를 찍어 2단계만 해도 돼요.
↳ 앞 단계 결과를 레퍼런스로 넣는 단계입니다 — 스튜디오 히스토리에서 방금 만든 결과를 붙이세요
이 단계 따라 하기 ⚡ 약 110프롬프트·설정 보기
모델 · GPT Image 2.5 Sunburst
첨부한 낙서를 실제로 찍은 사진으로 바꿔 주세요.

- 낙서에 그려진 것만 근거로 — 인물의 머리 모양, 안경, 옷 색, 배경의 큰 덩어리를 사진처럼 사실적으로
- 낙서의 어설픈 비율과 표정은 그대로 살려서, '이 낙서가 현실이 되면' 이런 모습이 되게
- 자연광 아래 휴대폰으로 찍은 평범한 사진 느낌
- 글자는 넣지 않기
| 품질 | medium |
| 비율 | 3:4 |
댓글